챗봇 다음은 판단 API다: Jev가 보여주는 AI 사용법의 변화
지금까지 AI를 쓰는 대표적인 방식은 채팅창이었다.
사람이 묻고, AI가 답한다. 이 방식은 자연스럽다. 인간은 원래 말로 일한다. 질문하고, 설명하고, 설득하고, 요약한다. 그래서 ChatGPT 이후의 AI 경험은 대부분 대화의 형태로 자리 잡았다.
그런데 조직 업무에서 정말 자주 필요한 것은 긴 답변이 아니다.
이 요청을 어느 팀으로 보낼지. 이 문서는 검토가 필요한지. 이 고객은 화가 난 상태인지. 이 작업은 자동 실행해도 되는지. 이 결과는 사람에게 넘겨야 하는지.
이런 것은 답변이라기보다 판단이다.
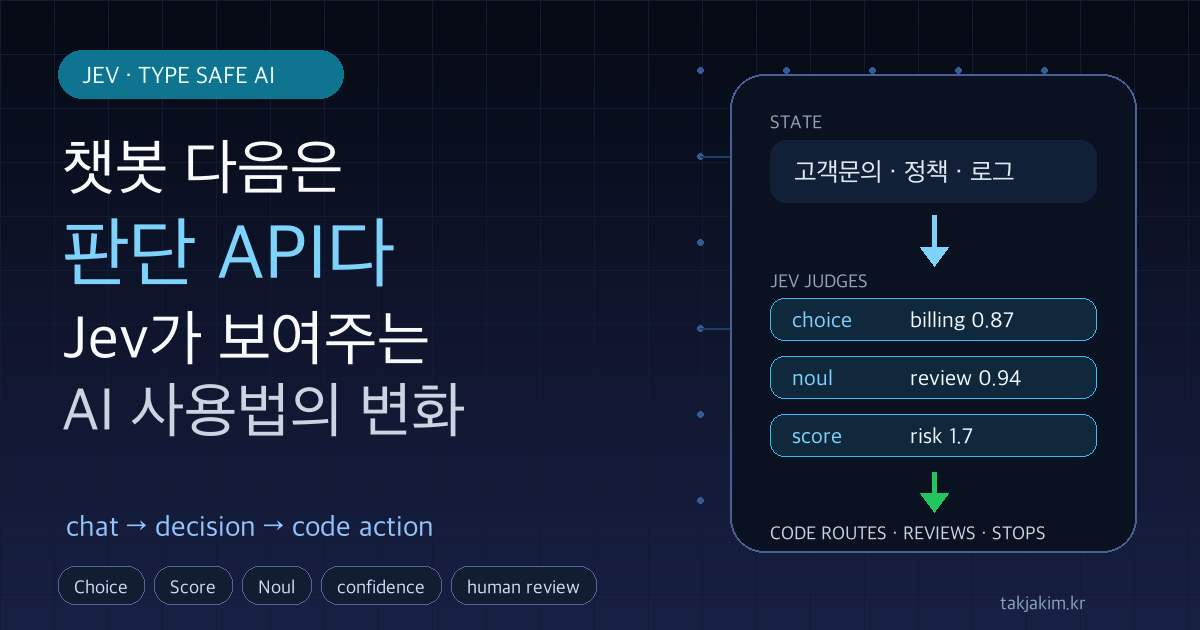
TypeSafe AI의 Jev가 흥미로운 이유가 여기에 있다. Jev는 챗봇이 아니다. 문장을 쓰지 않는다. 대신 정해진 질문에 대해 선택, 점수, yes/no 확률을 반환한다. 사람이 읽는 답변이 아니라, 코드가 바로 사용할 수 있는 판단값을 돌려준다.
어쩌면 AI의 다음 인터페이스는 채팅창이 아니라 if문 사이에 들어가는 판단 API일지도 모른다.
Jev는 답변하지 않는다. 판단한다
TypeSafe 문서는 Jev를 첫 번째 System One model이라고 설명한다. LLM이 사람이 읽을 텍스트를 생성하도록 설계됐다면, Jev는 소프트웨어가 바로 사용할 수 있는 빠르고 구조화된 판단을 반환하도록 설계됐다는 것이다.
구조는 단순하다.
state + typed questions → Jev → typed decisions + probabilities
여기서 state는 판단에 필요한 맥락이다. 고객 문의, 주문 내역, 환불 정책, 로그, 상담 기록, 문서 일부 같은 것들이 들어갈 수 있다. question은 그 state를 보고 내려야 할 좁은 판단이다.
예를 들어 고객이 이렇게 썼다고 해보자.
I was charged twice. Please refund the duplicate charge today.
챗봇이라면 답장을 쓴다.
Jev식 사용법은 다르다. 이런 질문을 던진다.
- 이 요청은 어느 팀이 처리해야 하는가?
- 환불 요청인가?
- 긴급한가?
- 고객의 분노 수준은 어느 정도인가?
그리고 답은 문장이 아니라 값으로 온다.
{
  "department": {
    "choice": "billing",
    "probabilities": {
      "billing": 0.87,
      "technical": 0.08,
      "account": 0.05
    },
    "confidence": 0.79
  },
  "refund_requested": {
    "noul": 0.94
  },
  "frustration": {
    "score": 1.7
  }
}
이 차이가 크다.
챗봇은 사람에게 말한다. 판단 API는 소프트웨어에게 신호를 준다.
왜 그냥 LLM JSON 모드로 하면 안 될까
물론 기존 LLM으로도 비슷한 일을 할 수 있다. 실제로 우리는 자주 이렇게 쓴다.
다음 고객 문의를 billing / technical / sales 중 하나로 분류해줘.
반드시 JSON으로만 답해.
설명하지 마.
마크다운 쓰지 마.
다른 필드 넣지 마.
생각해보면 이상한 프롬프트다.
텍스트를 생성하도록 훈련된 모델에게 “제발 텍스트를 생성하지 말고, 정해진 형식만 내놔”라고 부탁하는 셈이다. 그리고 그 결과를 다시 파싱해서 코드가 쓸 수 있는 값으로 바꾼다.
TypeSafe가 겨냥하는 미스매치가 이 지점이다. 코드가 필요한 것은 그럴듯한 문장이 아니라 분기 가능한 값이다. 어느 팀으로 보낼지, 검토가 필요한지, 자동 실행해도 되는지, 더 큰 모델에게 넘길지 같은 판단은 말보다 타입이 중요하다.
Jev는 이 과정을 처음부터 뒤집는다. 자유 텍스트를 만들고 구조화하는 게 아니라, 가능한 답의 공간을 먼저 정하고 그 안에서 확률을 반환한다.
이건 단순한 출력 형식의 차이가 아니다. AI를 대화 상대가 아니라 소프트웨어 부품으로 보는 관점의 차이다.
Choice, Score, Noul
Jev가 제공하는 기본 판단 형태는 세 가지다.
첫째, Choice. 정해진 옵션 중 하나를 고른다. 고객 문의를 billing, technical, account 중 어디로 보낼지 고르는 식이다. 결과에는 선택값뿐 아니라 옵션별 확률과 confidence가 함께 온다.
둘째, Score. 루브릭에 따라 점수를 매긴다. 고객의 분노 수준, 답변 품질, 위험도, 문서 완성도 같은 것을 순서 있는 기준에 놓는다.
셋째, Noul. yes/no 판단을 0과 1 사이 확률로 돌려준다. “이 메시지는 환불 요청인가”, “이 작업은 위험한가”, “이 응답은 사람 검토가 필요한가” 같은 질문에 적합하다.
이 세 가지가 중요한 이유는 소프트웨어와 잘 맞기 때문이다.
소프트웨어는 문장을 좋아하지 않는다. 소프트웨어는 타입, 값, 임계값, 분기, 로그를 좋아한다. Jev는 AI 판단을 이런 세계로 끌어온다.
if answers["refund_requested"].noul > 0.8:
    route_to_refund_team(ticket)

if answers["risk"].score >= 2.0:
    require_human_review(task)

if answers["department"].confidence < 0.75:
    route_to_human_triage(ticket)
else:
    route_to_handler(answers["department"].choice)
이 순간 AI는 채팅창 밖으로 나온다. 업무 흐름의 작은 판단 지점에 들어간다.
좋은 질문은 작아야 한다
TypeSafe 문서에서 가장 마음에 든 대목은 “atomic questions”다. Jev에게 넓고 복합적인 질문을 던지지 말고, 좁고 명확한 질문으로 쪼개라는 것이다.
예를 들어 이렇게 묻는 것은 별로 좋지 않다.
이 고객 요청을 자동 처리해도 되는가?
이 질문 안에는 여러 판단이 섞여 있다.
- 환불 요청인가?
- 정책상 가능한가?
- 고객이 화가 났는가?
- 금액이 큰가?
- 민감정보가 포함됐는가?
- 사람이 승인해야 하는가?
Jev식 설계는 이것들을 분리한다.
이 메시지는 환불 요청인가?
정책상 환불 가능한가?
고객 분노 수준은 어느 정도인가?
민감정보를 포함하는가?
담당자 승인이 필요한가?
그리고 최종 판단은 코드가 한다.
이 방식이 좋다. AI에게 모든 결정을 맡기는 게 아니라, AI가 잘할 수 있는 좁은 의미 판단을 여러 개 받고, 조직의 정책과 리스크 기준은 코드에 남긴다.
이건 내가 계속 이야기해온 에이전틱 AI의 승인 구조와도 연결된다. 에이전트가 행동하기 시작하면 중간중간 이런 판단 지점이 필요하다. 지금 상태에서 계속 가도 되는가. 이 도구를 실행해도 되는가. 이 결과를 사용자에게 보내도 되는가. 실패했으면 멈춰야 하는가.
AI 에이전트는 실행을 늘린다. 판단 API는 그 실행 사이에 브레이크와 분기점을 만든다.
판단 API는 에이전트의 가드레일이 될 수 있다
Jev의 흥미로운 사용처는 고객지원 라우팅만이 아니다. 에이전트 가드레일 쪽이 더 중요할 수 있다.
Pydantic AI 문서는 Jev를 사용해 에이전트의 도구 호출을 실행 전에 판단하는 예시를 보여준다. 예를 들어 에이전트가 셸 명령을 실행하려고 할 때, 그 명령이 데이터를 삭제하거나 비밀을 유출하는지 먼저 판단하게 하는 식이다.
이 구조는 간단하지만 의미가 크다.
Agent proposes tool call
        ↓
Jev judges risk
        ↓
allow / block / human review
        ↓
tool executes or stops
LangChain도 Jev를 모델 라우팅이나 Auto Mode 가드레일에 붙이는 예시를 제시한다. Braintrust와 Langfuse는 Jev를 eval scorer로 쓰는 방향을 보여준다. 응답이 고객에게 보내도 되는지, 사용자가 직전 답변에 불만을 표시했는지, 사람이 검토해야 하는지를 빠르게 판단하는 식이다.
여기서 보이는 공통점은 하나다.
Jev는 최종 답변자가 아니다. 중간 판단자다.
챗봇이 사용자의 질문에 대답하는 AI였다면, Jev 같은 판단 API는 시스템 내부에서 계속 “이 다음 행동이 맞나”를 묻는 AI다.
Type-safe는 truth-safe가 아니다
다만 여기서 조심해야 한다.
Jev나 TypeSafe 쪽 자료에는 zero hallucination, type-safe 같은 강한 표현이 나온다. 이 말은 그대로 받아들이면 위험하다.
Jev가 정해진 타입 밖으로 나가지 않는다는 것은 큰 장점이다. billing, technical, account 중 하나를 고르라고 했는데 “아마도 회계팀 비슷한 곳” 같은 문장을 반환하지 않는다는 뜻이다. JSON 파싱이 깨지거나 이상한 필드를 만드는 문제도 줄어든다.
하지만 타입이 안전하다는 것과 판단이 맞다는 것은 다르다.
billing이어야 할 요청을 technical로 고를 수 있다. 위험한 작업을 안전하다고 판단할 수 있다. 고객의 분노를 낮게 볼 수 있다. 형식은 맞지만 의미는 틀릴 수 있다.
그래서 이 문장은 꼭 붙어야 한다.
Type-safe는 truth-safe가 아니다.
Jev는 형식을 덜 틀리게 만들 수 있다. 판단을 항상 맞게 만들지는 않는다. 따라서 확률과 confidence는 자동 실행의 면허가 아니라 리스크 설계의 신호로 봐야 한다.
TypeSafe 문서도 calibration은 그룹 단위에서 측정된다고 설명한다. 어떤 범주의 예측들이 장기적으로 얼마나 맞는지를 보는 것이지, 개별 케이스 하나의 정답을 보장하는 것은 아니다.
그러니 조직은 이렇게 물어야 한다.
- 어떤 판단은 confidence 0.6이어도 자동 처리해도 되는가?
- 어떤 판단은 0.95여도 사람이 봐야 하는가?
- 어느 업무는 실패 비용이 낮은가?
- 어느 업무는 틀리면 학생, 고객, 조직에 직접 피해가 가는가?
- 어떤 경우에는 더 큰 reasoning model로 넘겨야 하는가?
결국 판단 API를 쓴다는 것은 확률을 받는 일이 아니다. 확률을 업무 리스크와 연결하는 일이다.
Jev는 표준이라기보다 신호다
Jev는 아직 초기 제품이다. TypeSafe는 Jev가 기존 LLM보다 훨씬 빠르고 저렴하다고 주장한다. 모델 페이지 기준 가격도 공격적이다. Jev 1.13은 입력 토큰 100만 개당 0.042달러, 출력 토큰은 무료로 제시되어 있다. 텍스트 생성이 아니라 판단값을 반환하니 비용 구조도 다르다.
하지만 속도와 비용, 성능에 대한 강한 수치는 대부분 TypeSafe 자체 평가와 초기 생태계 실험에 기대고 있다. 장기 운영 데이터, 독립 평가, 한국어 업무 데이터에서의 성능은 더 봐야 한다.
그러니 이 글은 “Jev를 당장 도입하자”는 글이 아니다.
내가 Jev를 중요하게 보는 이유는 제품 자체보다 방향 때문이다. Jev는 AI 사용법이 채팅창에서 업무 흐름 속 판단 API로 이동하고 있음을 보여준다.
생성형 AI의 첫 번째 대중적 인터페이스는 챗봇이었다. 두 번째 흐름은 에이전트다. 그리고 에이전트가 실제 업무에 들어오면, 중간중간 수많은 작은 판단이 필요해진다.
그 판단을 모두 거대한 LLM 호출로 처리할 필요는 없다. 모든 판단을 사람이 직접 볼 수도 없다. 규칙 기반 if문만으로는 애매한 의미 판단을 처리하기 어렵다.
그 사이에 판단 API라는 자리가 생긴다.
대학 행정에서 생각해보면 더 선명하다
이 흐름은 개발자 도구 이야기에만 머물지 않는다. 대학 행정이나 교육과정 운영에 대입하면 더 선명해진다.
예를 들어 대학 민원 triage를 생각해보자. 학생이 문의를 남긴다. 챗봇은 답변을 쓰려고 할 것이다. 하지만 실제 운영에서 먼저 필요한 것은 답변이 아닐 수 있다.
먼저 판단해야 한다.
- 학사팀, 장학팀, 취업지원팀, 학과 중 어디로 보내야 하는가?
- 긴급 대응이 필요한가?
- 민감정보가 포함됐는가?
- 규정 해석이 필요한가?
- 자동 안내 가능한가?
- 사람이 직접 확인해야 하는가?
장학 상담도 비슷하다.
- 소득분위 관련 문의인가?
- 성적 기준 관련 문의인가?
- 중복수혜 검토가 필요한가?
- 학생에게 불이익이 생길 수 있는가?
- 담당자 승인 없이 안내해도 되는가?
교육과정 추천도 마찬가지다.
- 이 과목은 학생의 진로 목표와 맞는가?
- 선수과목 조건을 만족하는가?
- 졸업요건 충족에 도움이 되는가?
- 추천 근거가 충분한가?
- 상담자가 개입해야 하는 경우인가?
이 질문들은 답변 생성보다 앞에 있다. AI가 무엇을 말할지보다, 업무가 어디로 흘러가야 하는지를 정한다.
컨설팅에서도 마찬가지다. 보고서 초안 생성보다 먼저 필요한 것은 이 이슈가 재정 문제인지, 조직 운영 문제인지, 교육과정 구조 문제인지, 지역 연계 전략 문제인지 판단하는 일이다. 그리고 그 판단의 확신이 낮으면 바로 결론을 내리지 말고 자료를 더 보거나 사람에게 넘겨야 한다.
이게 판단 API의 실무적 의미다.
챗봇은 인간 인터페이스, 판단 API는 시스템 인터페이스
나는 앞으로 AI 사용법을 이렇게 나눠보면 좋겠다고 생각한다.
챗봇은 인간 인터페이스다. 사람이 읽고, 말하고, 수정하고, 다시 묻는다. 지식 탐색, 글쓰기, 상담, 설명, 브레인스토밍에 강하다.
에이전트는 실행 인터페이스다. 파일을 읽고, 도구를 호출하고, 코드를 고치고, 보고서를 만들고, 외부 시스템을 건드린다.
판단 API는 시스템 인터페이스다. 소프트웨어 흐름 중간에서 작은 의미 판단을 수행하고, 그 결과를 코드가 받아서 분기한다.
chatbot: human → AI → text
agent: human → AI → tools → result
judgment API: state → AI judgment → typed signal → code action
이 세 가지는 서로 대체재가 아니다. 같이 쓰인다.
챗봇은 사용자와 대화한다. 에이전트는 일을 처리한다. 판단 API는 그 사이에서 무엇을 계속하고, 무엇을 멈추고, 무엇을 사람에게 넘길지 정한다.
여기서 Human-in-the-loop의 의미도 달라진다. 예전에는 사람이 AI의 답변을 마지막에 검토하는 구조였다. 판단 API가 들어오면 사람은 모든 것을 검토하지 않는다. 대신 어떤 판단에서 사람이 들어와야 하는지 임계값과 기준을 설계한다.
사람은 더 이상 모든 출력의 교정자가 아니다. 승인 구조의 설계자가 된다.
다음 질문은 “어디에 AI를 붙일까”가 아니다
Jev가 보여주는 변화는 간단하다.
AI를 채팅창으로만 보면, 질문은 이렇게 된다.
무엇을 물어볼까?
AI를 판단 API로 보면, 질문이 바뀐다.
업무 흐름의 어디에 판단을 끼울까?
고객 문의가 들어오는 순간. 문서가 발송되기 직전. 에이전트가 도구를 실행하기 전. 보고서가 외부로 나가기 전. 학생 상담 결과가 자동 안내되기 전. 예산·계약·규정과 관련된 판단이 내려지기 전.
이 지점마다 AI가 긴 답변을 쓸 필요는 없다. 필요한 것은 작은 판단이다.
계속할까. 멈출까. 넘길까. 다시 물을까. 더 큰 모델을 부를까. 사람에게 보낼까.
AI 사용법은 “무엇을 생성할까”에서 “어디에서 판단할까”로 이동하고 있다.
Jev는 아직 하나의 초기 제품일 뿐이다. 하지만 방향은 분명하다. 챗봇은 AI를 사람의 대화 상대로 만들었다. 에이전트는 AI를 실행자로 만들었다. 판단 API는 AI를 업무 시스템의 작은 판단 기관으로 만든다.
앞으로 조직의 AI 역량은 단순히 좋은 모델을 쓰는 데 있지 않을 것이다.
어떤 판단을 규칙으로 둘지, 어떤 판단을 AI에게 맡길지, 어떤 판단은 사람에게 넘길지, 그리고 그 경계를 어떤 확률과 책임 구조로 운영할지를 설계하는 데 있을 것이다.
챗봇 다음은 판단 API다.
그리고 그 변화는 생각보다 조용히, if문 사이에서 시작될 가능성이 크다.
참고자료
- TypeSafe AI, Introduction
- TypeSafe AI, System One
- TypeSafe AI, Models
- TypeSafe AI, How to build with TypeSafe
- TypeSafe AI, Home
- OpenRouter, TypeSafe: Jev 1.13
- LangChain, Building a Harness with Jev
- Pydantic AI, TypeSafe (Jev)
- Braintrust, Eval agent responses with Jev
- Langfuse, Using TypeSafe’s Jev for evals