AI가 쉬워질수록, 조직의 숙제는 더 구체적이 된다
BIG DATA & AI WORLD 2026 참관기 — 자연어 인터페이스에서 에이전트 운영까지
싱가포르 행사장에서 찍은 사진 한 장을 다시 꺼내 봤다.
Google Cloud가 후원하는 Data & AI Learning Theatre. 발표 화면에는 이런 질문이 떠 있었다.
What is the most popular language to get insights in 2026?
2026년, 인사이트를 얻기 위해 가장 많이 사용하는 언어는 무엇인가?
SQL, Python, Spark에는 취소선이 그어져 있었다. 그 아래 답은 Natural Language, 자연어였다.
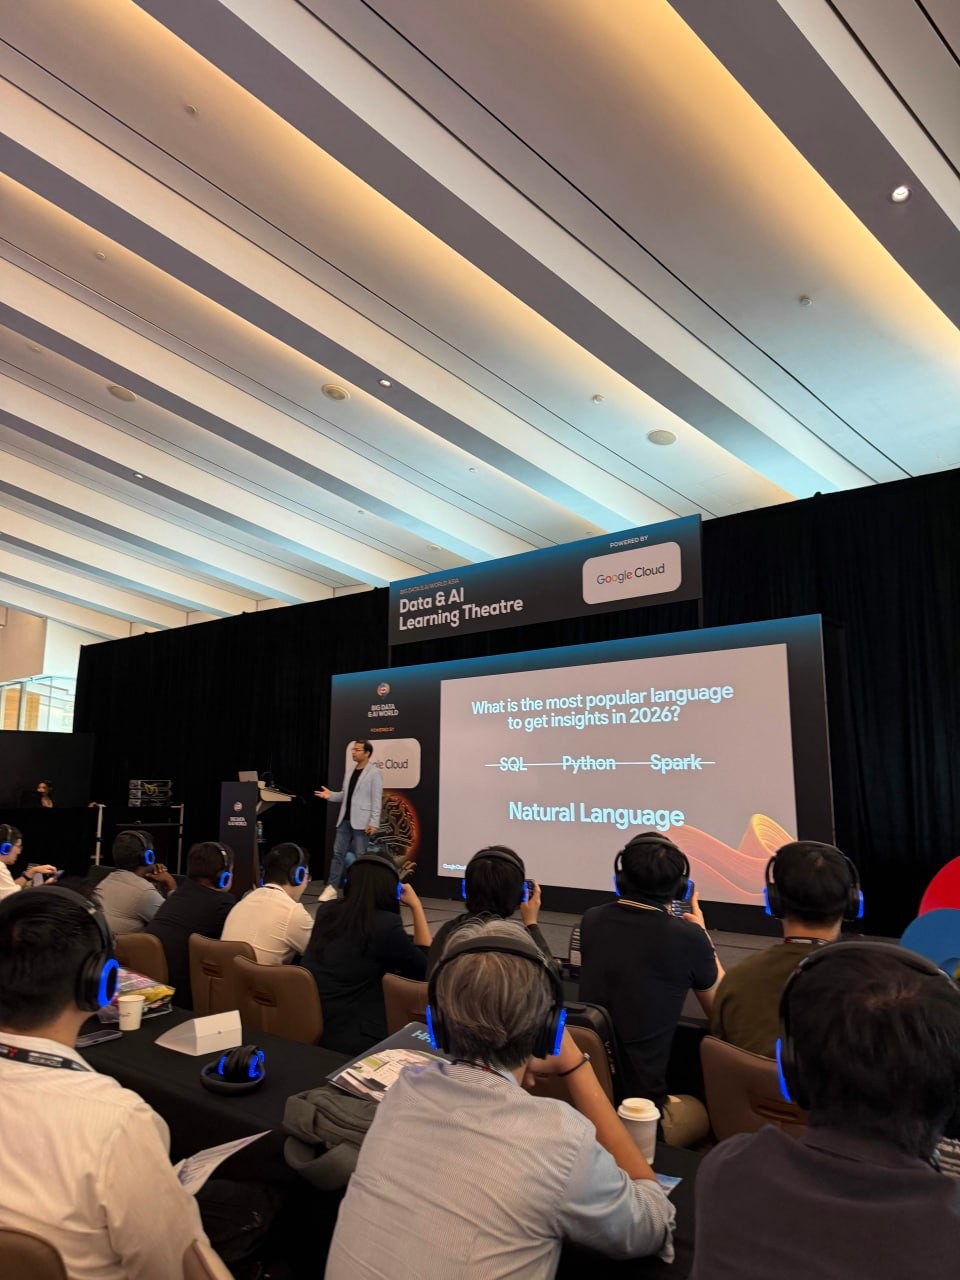
현장 발표 화면. SQL, Python, Spark에 취소선이 있고 Natural Language가 강조되어 있다.
기술적으로 엄밀한 순위라기보다 데이터 분석의 인터페이스가 어디로 향하고 있는지를 보여주는 메시지였다고 생각한다. 코드를 작성하는 대신 질문을 던지고, 데이터를 해석하고, 후속 분석을 요청하는 방식이다.
그렇다고 SQL과 Python이 사라진다는 뜻은 아니다. 자연어 질문 뒤에서는 여전히 데이터가 조회되고 코드가 실행된다. 사용자가 그 과정을 직접 다루지 않게 될 뿐이다.
이번 참관에서 내가 주목한 것도 그 ‘뒤쪽’이었다. AI에게 질문하기는 쉬워지고 있다. 하지만 조직이 AI에 일을 맡기려면 준비해야 할 것은 오히려 더 구체적이다.
챗봇을 잘 쓰는 것과 업무를 맡기는 것은 다르다
2026년 9월 29일부터 30일까지 싱가포르 Sands Expo & Convention Centre에서 열린 BIG DATA & AI WORLD 2026을 참관했다. Tech Week Singapore와 함께 개최된 행사로, 데이터와 AI뿐 아니라 클라우드, 보안, 개발·운영, 데이터센터를 연결해서 살펴볼 수 있었다.
나는 새로운 모델의 성능보다는 기업의 AI 도입과 운영에 초점을 맞췄다. 대학과 공공기관의 업무에도 적용할 수 있는지, 시범 서비스를 실제 운영으로 옮기려면 무엇이 필요한지가 궁금했다.
이 관점에서 Google Cloud가 참여한 첫날 패널 ‘Rethinking Technology Architecture to Enable Agentic AI’와 둘째 날 발표 ‘Beyond the Prompt: Blueprints for the Autonomous Enterprise’를 연결해 검토했다.
참관 내용과 공개 기술자료를 함께 정리하면서, AI 활용의 단위를 다시 생각하게 됐다. 한 번의 질문과 답변보다 업무의 시작부터 완료까지 이어지는 흐름을 봐야 한다는 것이다.
보고서 작성으로 예를 들면 차이가 선명하다.
챗봇 활용은 자료를 넣고 요약이나 초안을 요청하는 방식이다. 에이전트형 업무는 내부 자료를 찾고, 수치를 대조하고, 초안을 작성하고, 근거를 검토한 뒤 담당자에게 승인 요청을 보내는 흐름에 가깝다.
후자는 문장을 잘 만드는 것만으로 완성되지 않는다. 자료 접근권한, 도구 연결, 단계별 결과 전달, 오류 처리까지 필요하다. [[AI 에이전트]]를 도입한다는 것은 결국 기존 업무를 얼마나 명확하게 설명하고 나눌 수 있는지의 문제이기도 하다.
자연어 뒤에는 데이터 관리가 남는다
“우리 내부 문서를 연결하면 되지 않을까?”
AI 도입을 검토할 때 쉽게 떠올릴 수 있는 생각이다. 하지만 문서를 연결하는 것과 업무에 믿고 사용할 수 있는 근거를 제공하는 것은 다르다.
같은 업무 지침이 여러 버전으로 남아 있을 수 있다. 폐기된 양식이 공유 폴더에 있고, 최신 기준은 담당자의 메일에만 있을 수도 있다. 회의자료의 계획 수치와 결과보고서의 확정 수치도 구분해야 한다.
사람은 경험으로 이런 차이를 알아차리기도 한다. AI가 같은 판단을 하려면 자료의 상태와 우선순위를 확인할 수 있어야 한다.
그래서 [[그라운딩]]은 단순히 검색 기능을 붙이는 작업으로 끝나지 않는다. 어떤 자료가 유효한지, 누가 관리하는지, 언제 갱신되는지, 누구에게 공개할 수 있는지를 함께 정리해야 한다.
답변에도 문서명과 근거 위치가 표시되어야 한다. 자료가 충돌하거나 답을 찾지 못하면 그럴듯한 문장을 완성하기보다 담당자 확인을 요청하는 편이 낫다.
자연어 인터페이스가 편리해질수록 사용자는 내부 처리 과정을 덜 보게 된다. 그만큼 조직은 결과의 근거를 확인할 수 있도록 설계해야 한다.
연결할 수 있다고 실행해도 되는 것은 아니다
에이전트 기술을 살펴보면 ADK, MCP, A2A 같은 용어를 만나게 된다.
ADK는 에이전트를 개발하고 시험하는 도구, MCP는 데이터와 업무 도구를 연결하는 수단, A2A는 서로 다른 에이전트가 작업을 주고받는 방식으로 구분할 수 있다.
이런 연결 기술을 검토할 때 내가 먼저 떠올린 질문은 권한이었다.
문서를 검색할 수 있는 AI가 원문을 수정해도 되는가? 보고서 초안을 작성한 AI가 외부로 전송해도 되는가? 다른 부서의 자료에 접근할 때 누구의 권한을 적용해야 하는가?
읽기, 수정, 전송은 서로 다른 행동이다. 이를 하나의 ‘AI 사용 권한’으로 묶어서는 안 된다.
내부 보고서 업무라면 조회와 요약부터 시작할 수 있다. 원천 자료 변경이나 외부 배포에는 별도의 승인 조건을 두는 방식이다. 에이전트가 사용할 수 있는 도구도 해당 업무에 필요한 범위로 제한해야 한다.
AI 거버넌스가 실제로 작동하려면 이런 조건이 업무 절차에 들어가야 한다. “사람이 최종 책임을 진다”는 선언만으로는 부족하다. 누가 무엇을 확인하고, 어떤 상황에서 중단하며, 오류를 어떻게 되돌릴 것인지가 정해져 있어야 한다.
초안이 빨리 나왔다고 업무가 빨라진 것은 아니다
AI의 효과를 설명할 때 가장 보여주기 쉬운 것은 생성 속도다. 보고서 초안이 금방 나오고, 긴 회의록이 요약된다.
하지만 업무 담당자는 그다음부터 바빠질 수도 있다.
출처를 다시 찾고, 숫자를 대조하고, 잘못 적용된 기준을 수정해야 한다면 초안 작성시간이 줄어든 만큼 검토시간이 늘어난다. 문서는 더 많이 만들어졌지만 업무 완료는 늦어질 수 있다.
그래서 이번 참관보고서에서는 효과 판단 기준을 요청 접수부터 최종 검토까지의 시간으로 잡았다.
함께 봐야 할 항목은 다음과 같다.
- 담당자가 수정한 내용과 수정량
- 같은 오류로 다시 작업한 빈도
- 근거 확인에 필요한 시간
- 업무 한 건을 완료하는 데 든 사용료와 검토 인력 투입시간
이는 [[AI ROI]]를 생성량이나 사용 횟수로만 평가하지 않기 위한 기준이다.
에이전트 구조가 복잡해질수록 비용도 다시 봐야 한다. 여러 역할이 모델과 도구를 반복 호출하면 사용량이 늘어난다. 단순한 문서 요약에 여러 에이전트를 붙였을 때 실제로 품질이나 검토 부담이 개선되는지도 확인해야 한다.
역할을 많이 나눈 구조가 항상 더 좋은 구조는 아니다. 간단한 방식으로 시작하고, 분업의 효과가 확인될 때 복잡도를 높이는 편이 현실적이다.
대학과 공공기관에서는 업무 하나부터
대학과 공공기관에는 반복적인 자료 검색과 문서 작성 업무가 많다. 내부 보고서, 회의자료, 사업 지침을 찾고 비교하는 일이 좋은 출발점이 될 수 있다.
다만 처음부터 기관 전체를 연결하는 그림보다는, 반복 빈도가 높은 업무 하나를 선정하는 편이 낫다고 생각한다.
먼저 현재 처리시간과 검토 부담을 기록한다. 자료 위치, 관리 담당자, 갱신 주기를 정리하고 정상 사례와 예외 사례를 만든다.
다음으로 권한이 확인된 자료에 한해 검색·요약 기능을 시험한다. 최신 자료만 있는 질문뿐 아니라 오래된 자료가 섞인 질문, 근거가 충돌하는 질문, 답이 없는 질문도 포함해야 한다.
마지막에는 최종 검토까지의 시간이 실제로 줄었는지 판단한다. 효과가 확인되면 범위를 넓히고, 그렇지 않으면 검색 방식이나 업무 범위를 조정한다. 경우에 따라서는 중단하는 선택도 가능해야 한다.
이런 접근은 디지털 전환을 기술 설치가 아니라 업무 개선으로 다루기 위한 방법이다. 어떤 모델을 도입했는지보다 어떤 업무에서 무엇이 달라졌는지를 설명할 수 있어야 한다.
AI 활용교육도 업무 절차와 연결되어야 한다
이번 참관 내용을 교육과 HRD 관점에서도 생각해 봤다.
조직의 AI 교육이 프롬프트 작성법에만 머무르면 실제 운영에서 필요한 역량을 놓칠 수 있다. 좋은 요청을 만드는 것에 더해, 결과의 근거를 확인하고 자동 처리의 범위를 판단하는 능력이 필요하다.
어떤 자료를 입력해도 되는지, 오류를 발견하면 누구에게 보고해야 하는지, 언제 AI의 결과를 사용하지 말아야 하는지도 알아야 한다.
이를 담당자의 주의력에만 맡기기는 어렵다. 교육과 함께 승인 단계, 자료 접근권한, 오류 보고 경로를 정비해야 한다. AI 리터러시와 조직의 운영 설계를 따로 추진하기 어려운 이유다.
대학의 교육과정에서도 비슷한 질문이 가능하다. AI 도구를 사용하는 경험과 함께, 결과를 검토하고 실제 과업을 완료하는 경험까지 설계할 수 있을까. 도구 조작 능력만으로는 업무 수행 역량을 충분히 설명하기 어렵다.
다음에는 모델보다 업무 흐름을 먼저 볼 것이다
사진 속 ‘Natural Language’라는 문구는 AI 사용의 진입장벽이 낮아지고 있다는 메시지였다. 나는 그 장면을 보면서 사용자에게 보이지 않게 된 작업들을 생각하게 됐다.
데이터를 관리하는 일. 접근권한을 정하는 일. 근거를 확인하고 잘못된 실행을 멈추는 일. 결과를 실제 업무에 사용할지 판단하는 일.
이 작업들은 자연어로 요청할 수 있게 되었다고 사라지지 않는다.
이번 참관을 바탕으로 다음 AI 과제를 검토할 때는 모델 선택에 앞서 업무 흐름부터 그려보려고 한다. 어떤 자료를 받아 어떤 결과를 만들고, 어느 단계에서 사람이 확인하며, 무엇을 기준으로 완료를 판단할 것인지부터 정리하는 것이다.
조직의 AI 도입 성과는 멋진 시연 다음에 드러난다. 담당자가 근거를 다시 찾느라 시간을 쓰지 않아도 되는지, 수정 부담이 줄었는지, 오류가 났을 때 대응할 수 있는지. 일상적인 업무에서 그 차이를 확인하고 싶다.